给 AI 编程限个上下文:把窗口砍到 300k 反而更省
我一直觉得上下文窗口越大越好。
模型标 1M,我就想把它拉满。反正窗口空着也是空着,多塞点历史,AI 不至于忘事。直到账单出来,我才发现这个想法挺贵的。
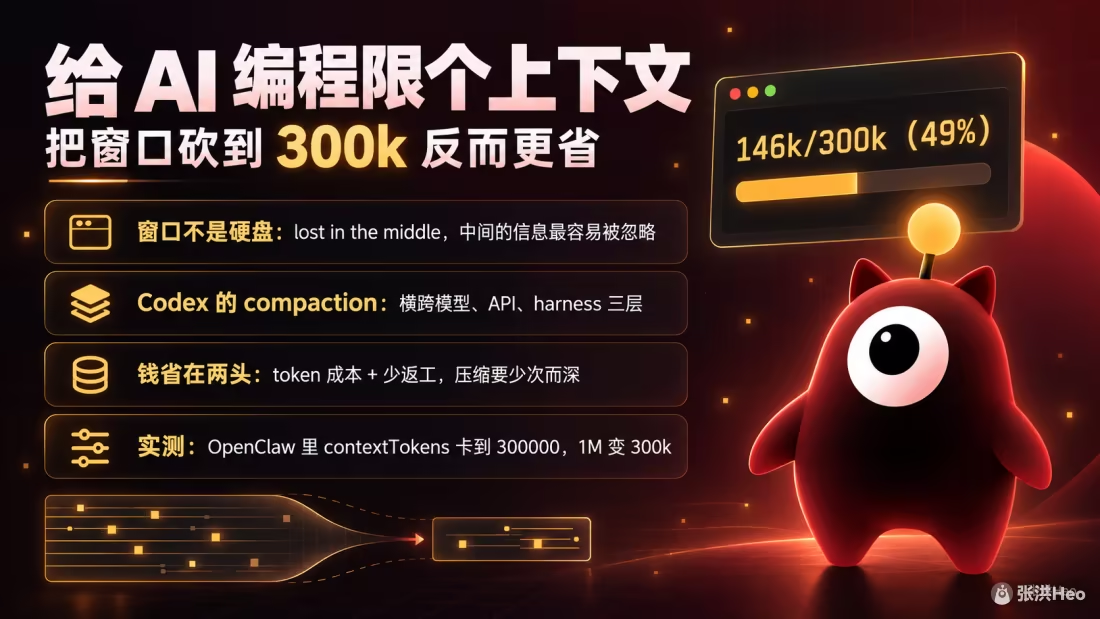
后来我把 OpenClaw 里所有模型的活动上下文都压到了 30 万 token。同样的活儿,花费明显下来,体验也没变差。巧的是,Codex 官方一直是这么干的。
上下文窗口不是硬盘
我们习惯把上下文当成内存,越大越能装。其实它更像一张桌子,文件摊得越开,越难一眼找到要的那份。
这个现象有名字,叫 lost in the middle。模型对开头和结尾的信息记得最清楚,塞在中间的内容容易被忽略。窗口拉得越大,中间那片被浪费的区域就越大。Liu 等人 2023 年的研究就发现,把关键文档放在长上下文的中间位置,检索准确率会明显下滑,有时候还不如干脆不给。
有长上下文基准测过编程场景,多数模型的准确率峰值落在 64K 到 128K 之间,之后就开始往下走。也就是说,窗口标 1M,不代表 1M 都好用。
窗口大还有个更直接的代价。每多塞一个 token,都要按输入计费。agent 干活的模式是反复调用模型,历史会被一遍遍重新发出去。上下文越长,每轮成本越高,而且是滚雪球式的。
Codex 是怎么做的
Codex 产品负责人 Alexander Embiricos 在 Lenny’s Podcast 那期采访里讲过这件事。大意是,让模型连续工作二十几个小时,一定会超出上下文窗口,所以 OpenAI 做了一个叫 compaction 的机制。
他特别强调,compaction 不是单点功能,它横跨三层。模型本身要理解这个概念,知道自己快接近窗口上限、即将被放进一个新窗口,得提前把关键状态整理好。API 层要提供对应的接口,触发这次切换。harness 层要负责把要交接的内容准备好。
三层一起改,才让”跑一整夜”变成常态。OpenAI 后来发布 GPT-5.1-Codex-Max 时也专门提过,它是第一个原生支持跨多个上下文窗口工作的模型,靠修剪历史、保留重点来突破窗口限制。官方给的数据是,同样推理强度下它比 GPT-5.1-Codex 表现更好,思考 token 还少了 30%。
还有一篇 OpenAI 工程师 Michael Bolin 写的《Unrolling the Codex agent loop》,把 agent 循环讲得很细。里面提到,Codex 每次请求都会把历史作为前缀重新发一遍。为了保证请求无状态、支持零数据留存,它没有用 previous_response_id 这类能省流量的接口。所以历史越长,发出去的东西越多。省钱的唯一办法,就是别让历史无限膨胀。
钱省在哪
省在两头。
一头是直接的 token 成本。活动上下文每小一截,每一轮重发的输入就少一截。一个任务动辄几十上百轮,这个差距会被放大很多倍。
另一头是返工。上下文进入退化区间以后,模型更容易跑偏、自相矛盾,产出需要重试的结果。一次返工的代价是全价输入加输出,比主动做一次压缩贵得多。社区里有实测分析算过,成本曲线的最低点在中间:压缩太少会质量衰减然后返工,最贵;压缩太频繁,每次都要重建缓存,偏贵;适中才最划算。
顺便说下缓存。主流 API 的 prompt caching 对命中的前缀打很低的折扣,但一旦压缩发生,摘要后的新上下文对不上旧缓存,下一轮就必然全价。所以压缩这件事,宁可少次而深,别频繁来回压。
我自己的调法
我用的是 OpenClaw,配置入口是每个模型条目下的 contextTokens。
有个坑要提醒。contextWindow 和 contextTokens 是两回事。前者是模型原生窗口的元数据,后者才是你实际允许它用的活动输入预算。我想限制的是后者,改错了没效果。
具体做法是给每个 provider 的每个 model 补一条 contextTokens: 300000。原生窗口标 1M 的照旧标着,但实际活动窗口卡在 30 万。改完用 session_status 看了一眼,上下文占用从原来的 1M 口径变成了 95k/300k。
调之前我其实有点担心,怕窗口小了模型记不住事。跑下来发现担心是多余的。30 万 token 对绝大多数任务都够用。真正需要长期记住的东西,本来就该放进 memory 或者笔记里,而不是一直挂在活动上下文里占着预算。
上下文窗口是个预算,不是一个越大越好的指标。把它限制在一个合理区间,再用压缩和外部记忆接住溢出的部分,同样的活儿能省下不少钱,模型的状态也更稳。
Codex 这么干,我也这么干。